> ## Documentation Index
> Fetch the complete documentation index at: https://opencompass-docs-preview-pr-335-0.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
# 项目简介
了解 AgentCompass 评测什么,然后完成安装或生成可直接运行的命令。
 ## 从这里开始
使用 Python 3.12 或更新版本从源码安装 CLI。
输入 model 与 Environment 设置,预览生成的命令并运行一个真实任务。
搜索 Benchmark 目录,生成可直接运行的完整评测命令。
查看源码、关注版本发布、报告问题并加入社区。
## 什么是 AgentCompass?
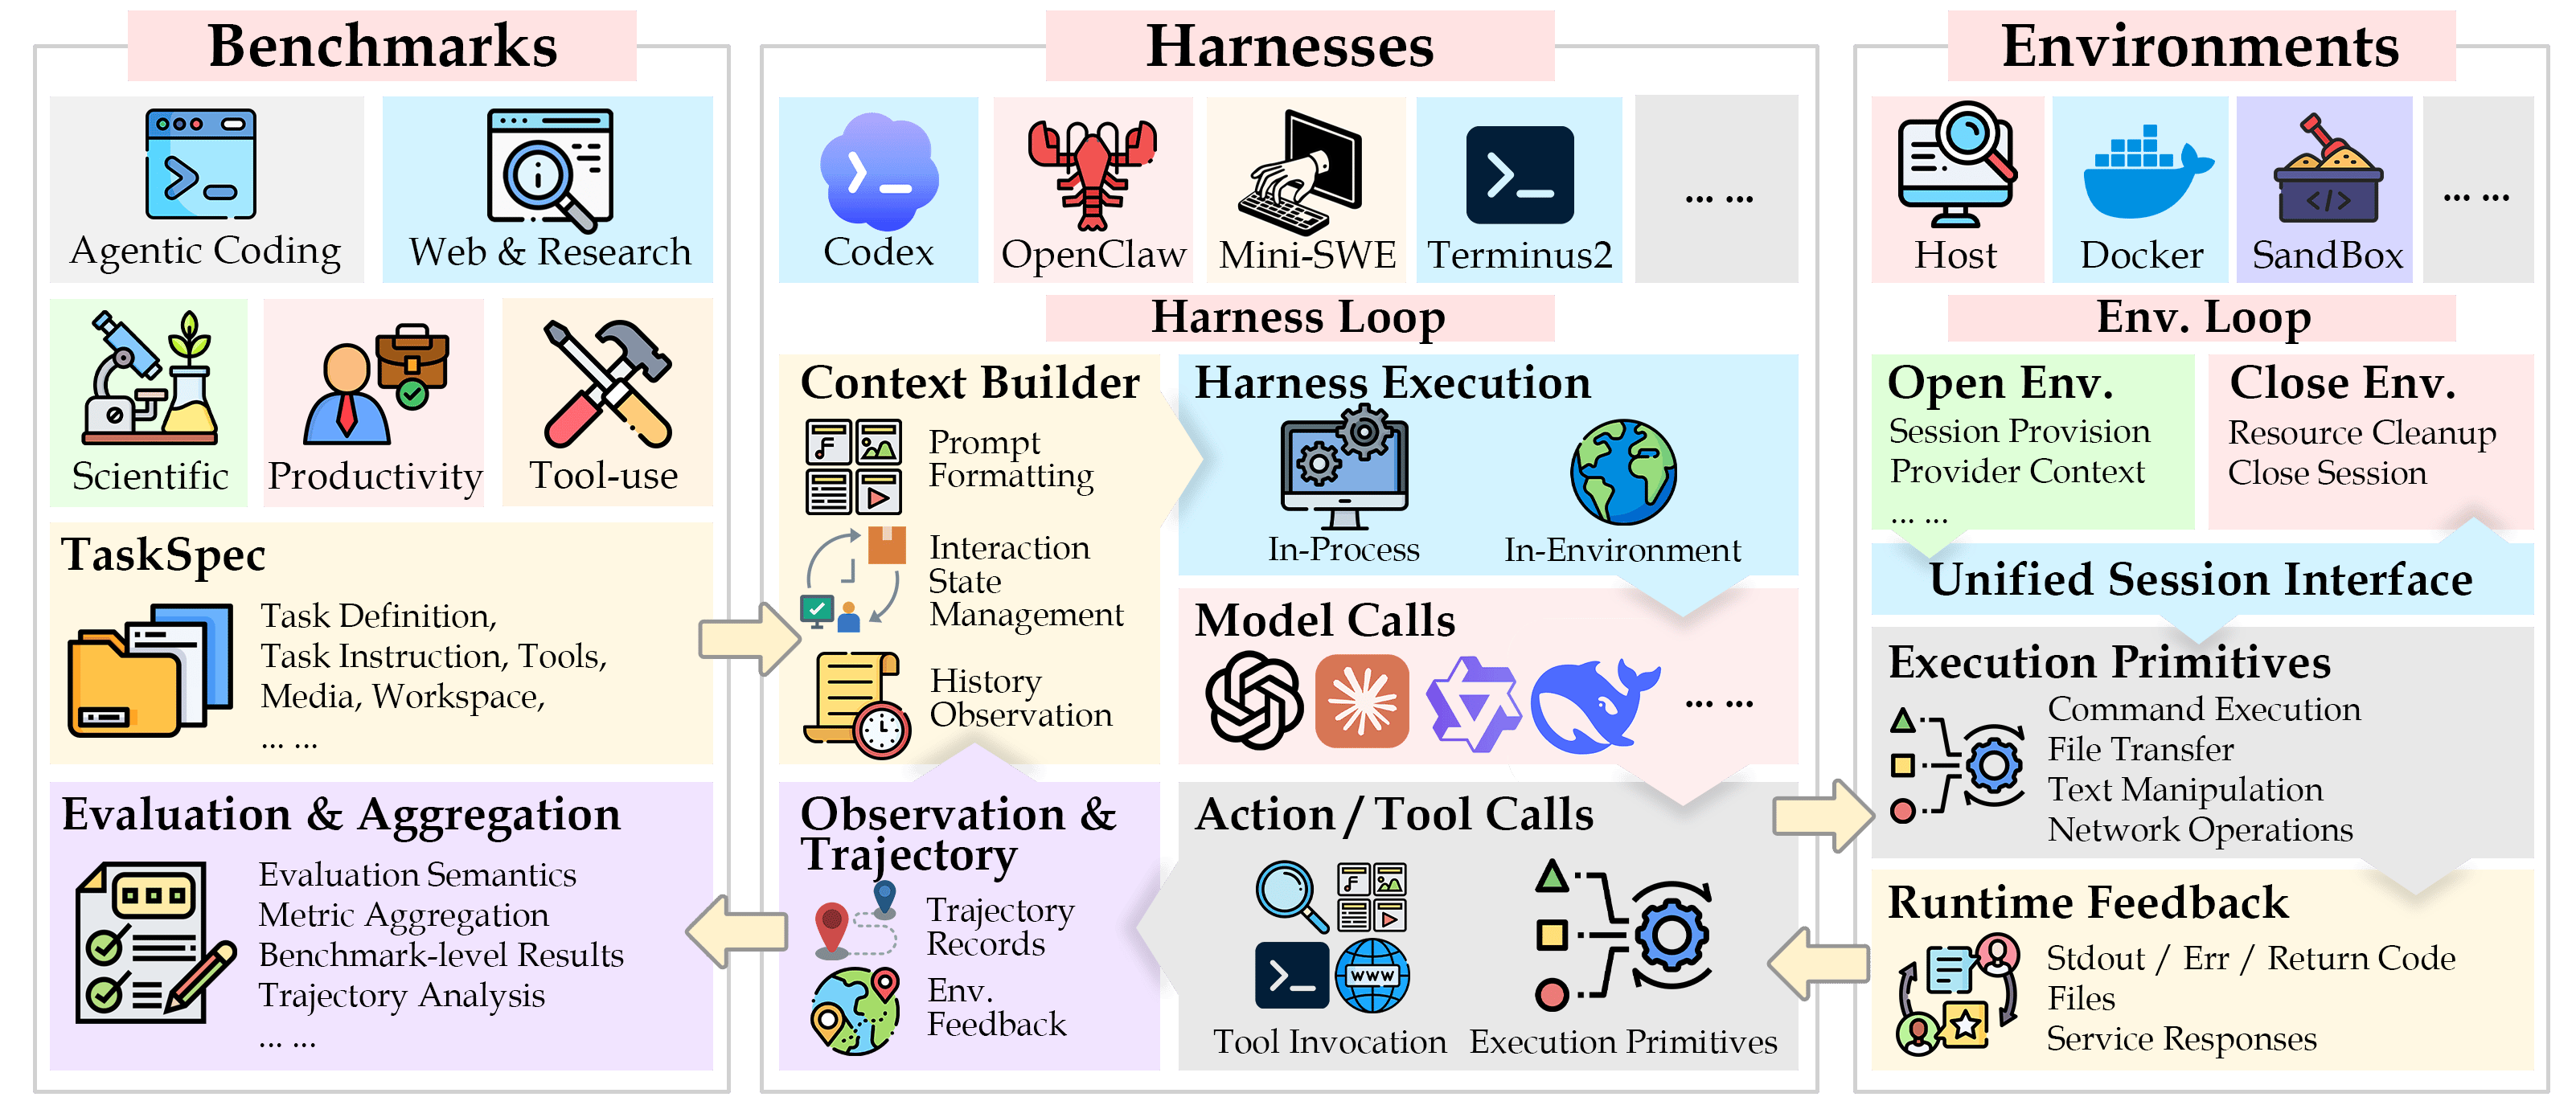
AgentCompass 是面向下一代 agent 的统一开源评测框架。它采用高度解耦的模块化设计,便于灵活扩展和集成。为解决现有 agent 评测流程碎片化、组件耦合紧密和可复现性不足的问题,AgentCompass 将 **Model、Benchmark、Harness 和 Environment** 四个核心模块解耦,使用户能够在统一标准下切换任务、agent 工作流和 Environment,而无需重复实现复杂执行逻辑。
AgentCompass 原生支持广泛认可的 Benchmark 和主流 Harness,并提供稳定、安全的 sandbox Environment,且会持续扩展集成。它还提供覆盖任务调度、环境交互、指标聚合和轨迹分析的端到端评测流程,以及防止奖励黑客的机制,为 agent 研究和多维能力评测提供统一、易用且可复现的开源基础设施。
在[研究论文集合](/zh/research/overview)中查阅 AgentCompass 团队的论文。
AgentCompass 直接通过 CLI 或 Python SDK 运行评测。主要运行路径不需要长期运行的 API 服务器、队列、工作进程池或全局 LLM 网关。
## 核心特性
* **可组合的模块化架构**:通过稳定协议解耦 Model、Benchmark、Harness 和 Environment,使现有组件可以跨任务、agent 和执行后端复用与自由组合。
* **统一的 agent 执行接口**:从单轮 model 调用到 Claude Code、Codex、OpenHands、OpenClaw、Mini-SWE-agent 和 Terminus2 等主流 Harness,都可通过统一会话接口在本地、Docker 或远程 sandbox 中运行。
* **异步、容错的评测 runtime**:支持并发任务调度、增量结果持久化、失败重试和断点评测,适合长期运行、I/O 密集型的 agent 轨迹,降低大规模评测成本。
* **完整轨迹记录与行为分析**:统一记录推理过程、工具调用、环境反馈、词元用量和推理延迟;可插拔分析器可以识别跨 model、环境和框架的失败,以及截断、重复生成和奖励黑客等异常行为。
* **广泛的能力和 Benchmark 覆盖**:集成多个能力维度下公认的 Benchmark,通过一致的指标和轨迹协议评估异构 model 与 agent。
* **可扩展且可复现**:使用轻量注册机制集成新的 Benchmark、Harness、Environment、Recipe 和分析器,并保留完整配置、任务日志和聚合结果,使评测可审计、可恢复、可复现。
## 继续了解
了解高级运行选项,并查询 Benchmark、Harness、Environment 和结果处理方式。
理解 runtime 约定、生命周期和组件设计边界。
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.